Auto-labeling em arquivos antigos do SharePoint: o que mudou e onde entra o On-demand Classification
O Purview agora consegue aplicar o label padrão de uma biblioteca a arquivos antigos do SharePoint sem o usuário abri-los. Mas isso não é o mesmo que On-demand Classification.
A Microsoft está liberando uma forma de aplicar Sensitivity Labels a arquivos antigos no SharePoint sem depender de alguém abrir ou editar o documento.
Essa é uma mudança importante no Microsoft Purview, mas existe uma diferença que precisa ficar clara: aplicar o label padrão de uma Document Library em arquivos existentes não é a mesma coisa que inspecionar o conteúdo desses arquivos para classificá-los.
São duas capacidades diferentes:
- Auto-labeling para existing files, usando o Default Sensitivity Label da SharePoint Document Library.
- On-demand Classification, para reexaminar conteúdo histórico usando os classificadores atuais do Purview.
As duas atacam o problema de dados parados. Mas fazem isso de maneiras completamente diferentes.
O problema que existia no SharePoint
Uma SharePoint Document Library pode ter um Default Sensitivity Label.
Por exemplo:
Finance → Confidential
Esse mecanismo cria uma proteção mínima baseada no local onde o documento está armazenado. O problema era o comportamento com conteúdo histórico.
Novos arquivos enviados para a biblioteca recebiam o label. Arquivos existentes editados também podiam recebê-lo. Mas documentos que já estavam armazenados e permaneciam intocados poderiam continuar sem label.
A própria documentação da Microsoft ainda descreve o Default Library Label como um mecanismo de location-based labeling, sem inspeção de conteúdo.
É justamente esse gap que a nova capacidade tenta fechar.
1. Default Library Label passa a alcançar arquivos existentes
O Microsoft 365 Roadmap ID 559105 introduz uma opção de Auto-labeling Policy voltada especificamente aos arquivos existentes em SharePoint.
A lógica é simples.
Imagine esta biblioteca:
Finance
Default Sensitivity Label = Confidential

├── Budget-2026.xlsx       → Confidential
├── Forecast.docx          → Confidential
├── Contract-2023.pdf      → sem label
└── Contract-2021.docx     → sem label
Os dois últimos arquivos estavam parados desde antes da configuração do label.
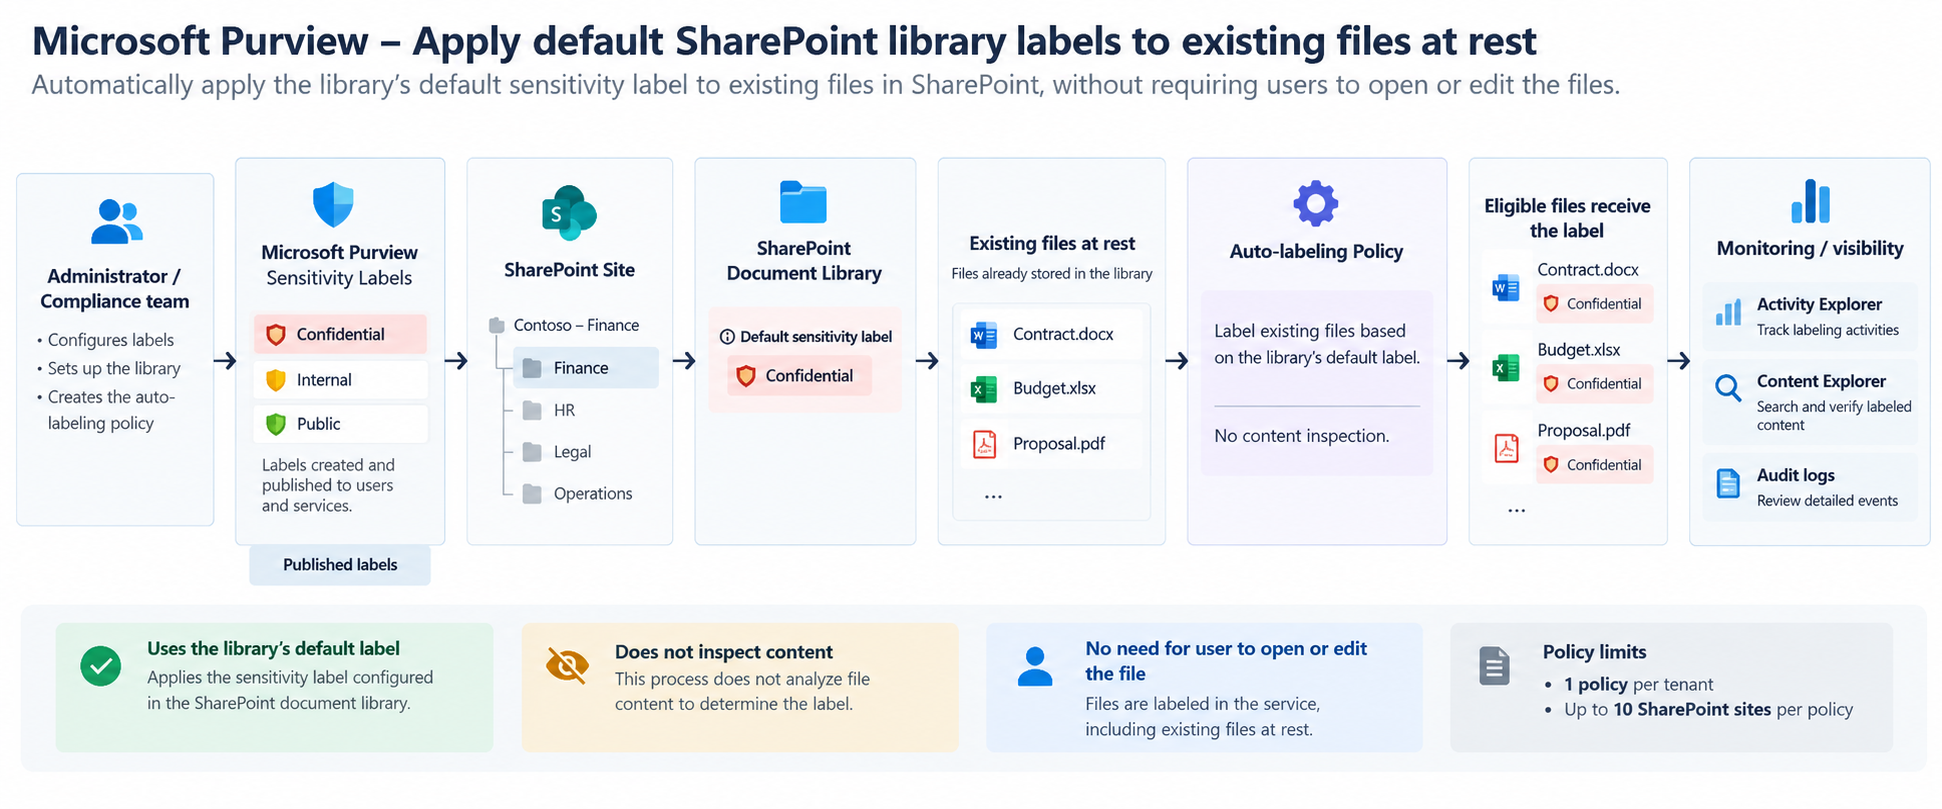
Com a nova política, o Purview consegue avaliá-los no serviço e aplicar o Default Sensitivity Label da própria biblioteca, sem exigir que alguém abra ou edite cada documento. A documentação já descreve esse fluxo explicitamente.
O ponto mais importante: não existe content inspection para escolher o label
Nesse cenário, a Auto-labeling Policy não inspeciona o conteúdo do arquivo para determinar qual label aplicar. Ela utiliza o Default Sensitivity Label configurado na SharePoint Document Library.
Isso faz sentido quando o local do documento já define sua classificação mínima.
Uma biblioteca de contratos confidenciais, por exemplo, não precisa redescobrir arquivo por arquivo se a decisão arquitetural já estabelece que tudo naquele repositório deve ter pelo menos determinado nível de proteção.
Cuidados com essa abordagem
A nova capacidade não deve ser tratada como uma varredura genérica do SharePoint.
Hoje, a documentação informa algumas limitações importantes:
- existe uma policy desse tipo por tenant;
- ela pode incluir até 10 SharePoint sites por vez;
- para ambientes maiores, é possível processar um lote e depois alterar a seleção para os próximos sites;
- arquivos abertos, checked out, bloqueados, não suportados ou com determinados tipos de criptografia podem não ser processados.
Também continuam valendo os pré-requisitos de Information Protection no SharePoint, incluindo habilitar Sensitivity Labels para Office files em SharePoint e OneDrive e ter os labels adequadamente criados e publicados.
Disponibilidade
O Roadmap ID 559105 aponta General Availability em outubro de 2026. O Message Center informa rollout Worldwide começando no início de outubro de 2026, com conclusão esperada até meados de outubro de 2026.
Isso é importante porque estamos no início de outubro: GA no roadmap não significa que a opção já apareceu em todos os tenants.
A validação correta é verificar a disponibilidade no próprio ambiente.
2. E se eu quiser inspecionar o conteúdo dos arquivos antigos?
Aí estamos falando de outro recurso:
On-demand Classification
O On-demand Classification foi desenvolvido exatamente para alcançar arquivos que ficaram fora dos mecanismos contínuos de classificação porque:
- não são modificados há muito tempo;
- nunca foram classificados;
- ou precisam ser reavaliados com classificadores mais recentes.
Isso resolve um problema diferente.
Imagine que sua organização criou hoje um novo Sensitive Information Type:
SIT: Customer Contract NumberVocê já possui cinco anos de arquivos armazenados no SharePoint.
Uma Auto-labeling Policy baseada nesse SIT não significa automaticamente que todo esse backlog histórico será reprocessado.
A documentação da própria Microsoft alerta que os SITs usados pelo Auto-labeling avaliam conteúdo criado ou modificado depois da criação ou última alteração do SIT. Para arquivos antigos que permaneceram inalterados, a recomendação é usar On-demand Classification.
A arquitetura muda completamente:
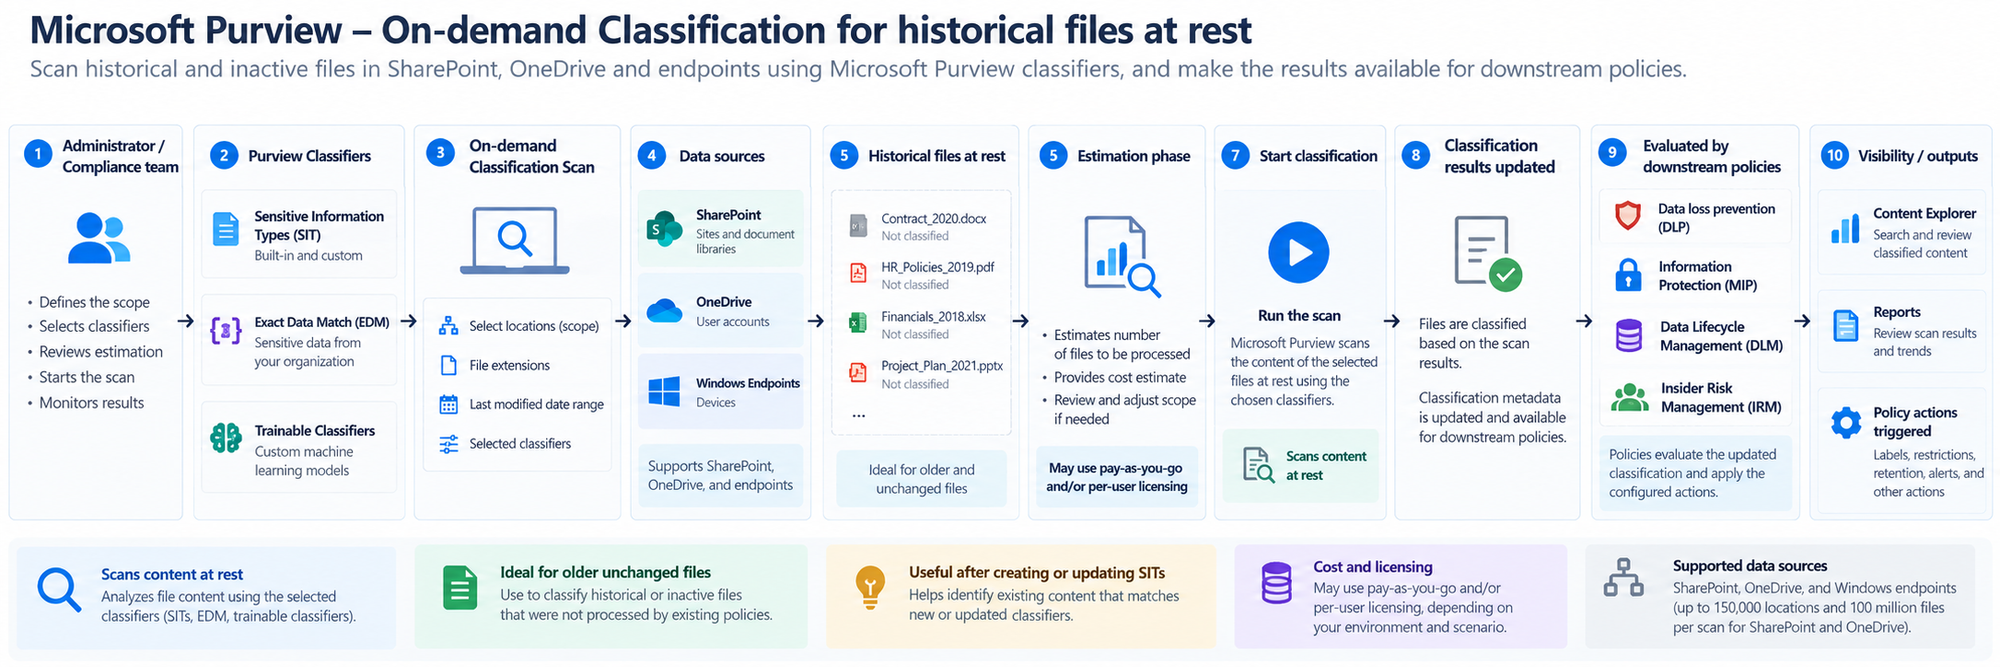
Aqui existe efetivamente análise do conteúdo.
O administrador consegue definir:
- SharePoint sites e OneDrive accounts;
- período da última modificação;
- extensões;
- classificadores que serão utilizados.
O processo começa por uma estimativa. Depois da revisão do escopo e custo, o administrador inicia a classificação.
Um ponto importante: On-demand Classification não deve ser confundido com o ato de aplicar um Sensitivity Label.
Ele atualiza a classificação dos arquivos. Depois disso, esses resultados alimentam as políticas aplicáveis. A Microsoft documenta que arquivos processados podem ser avaliados por políticas de DLP, Information Protection, Data Lifecycle Management e Insider Risk Management.
E o custo?
Aqui existe outra diferença relevante.
On-demand Classification pode utilizar pay-as-you-go, licenciamento por usuário ou uma combinação dos dois, dependendo das capacidades e do licenciamento do ambiente.
Por isso eu não começaria um scan grande simplesmente porque a funcionalidade existe.
Primeiro:
- defina o problema que está tentando resolver;
- selecione os classificadores necessários;
- restrinja o escopo;
- rode a estimativa;
- valide custo e quantidade de arquivos;
- só então inicie a classificação.
Em ambientes grandes, essa etapa faz parte do desenho da solução.
Disponibilidade
Diferentemente da capacidade do Roadmap 559105, On-demand Classification já possui documentação operacional para SharePoint, OneDrive e endpoints e pode ser utilizado em tenants elegíveis, conforme licenciamento e disponibilidade da capacidade no ambiente
As duas soluções lado a lado
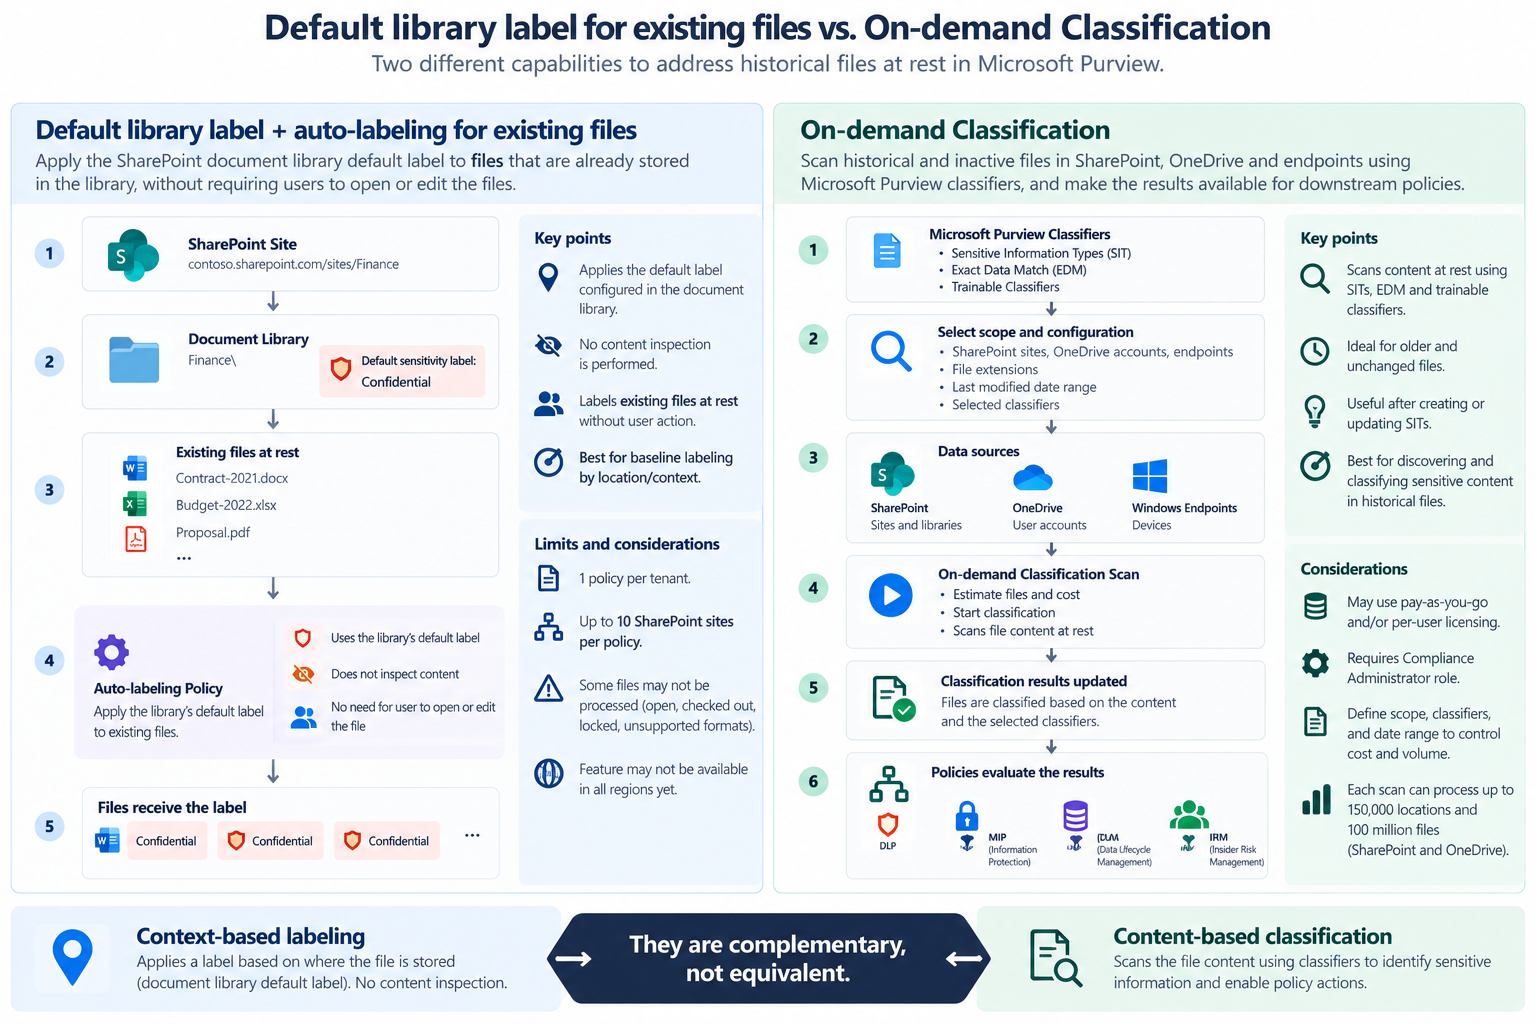
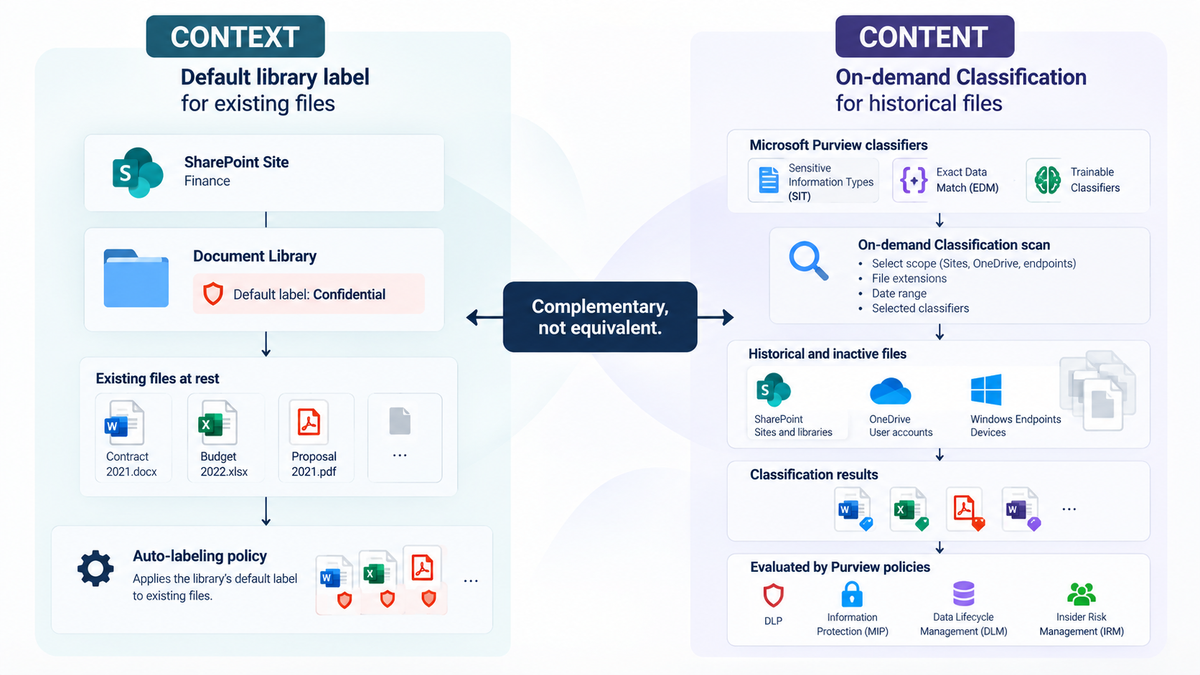
As duas capacidades lidam com arquivos históricos, mas resolvem problemas diferentes: uma aplica proteção com base no contexto da biblioteca; a outra reavalia o conteúdo usando classificadores.
| Comparação | Default Library Label em existing files | On-demand Classification |
|---|---|---|
| Problema | Arquivos antigos não receberam o label padrão da biblioteca. | Arquivos históricos não foram classificados com os classificadores atuais. |
| Critério | Localização / Document Library. | Conteúdo do arquivo. |
| Inspeciona conteúdo? | Não | Sim |
| Usa SITs / Classifiers? | Não para escolher o label. | Sim. |
| Depende do usuário abrir o arquivo? | Não | Não |
| Principal resultado | Aplica o Default Sensitivity Label configurado na biblioteca aos arquivos elegíveis. | Atualiza a classificação dos arquivos para que os resultados possam alimentar políticas. |
| SharePoint | Sim | Sim |
| OneDrive | Não neste cenário específico. | Sim |
| Endpoints | Não | Sim |
| Status em outubro/2026 | Rollout GA em andamento |
Disponível para tenants elegíveis
Validar licenciamento e disponibilidade no ambiente.
|
O On-demand Classification em endpoints classifica arquivos históricos, mas não substitui o Endpoint DLP nem executa diretamente seu enforcement.
Na prática, elas são complementares
Eu não trataria essas capacidades como duas opções concorrentes.
Uma arquitetura madura pode usar ambas.
O Default Sensitivity Label da biblioteca estabelece o baseline:
Confidential é o baseline definido para essa library, respeitando labels existentes e suas regras de precedência.O On-demand Classification responde outra pergunta:
O que existe dentro dos arquivos históricos e que nossas regras atuais identificariam como sensível?E o Auto-labeling baseado em conteúdo continua fazendo o trabalho contínuo de transformar determinadas classificações em labels quando as condições forem atendidas.
Isso cria três camadas diferentes:
Contexto → Classificação → Proteção
WHERE IS THE DATA?
SharePoint Library
Default Label
        ↓
WHAT IS IN THE DATA?
SIT / EDM / Classifier
        ↓
WHAT SHOULD HAPPEN?
Sensitivity Label / DLP / DLM / IRM
Essa separação parece pequena, mas muda completamente o desenho.
A novidade do Roadmap 559105 não transforma Default Library Labels em classificação baseada em conteúdo.
Ela resolve um gap específico e importante: fazer a proteção definida para uma biblioteca alcançar também os arquivos que já estavam parados nela.
Quando a pergunta passa a ser “o que existe dentro dos arquivos antigos?”, entramos no território do On-demand Classification.
E entender essa diferença evita criar uma arquitetura esperando que uma dessas funcionalidades faça o trabalho da outra.
Referências oficiais

Microsoft 365 Roadmap — ID 559105
 ReezaAli149
Microsoft Learn — Automatically apply a sensitivity label to Microsoft 365 data
 MSFTTracyP
Microsoft Learn — Configure a default sensitivity label for a SharePoint document library
 k-reagle
Microsoft Learn — On-demand Classification